Case study · 2026
JobEasy
日本で就職活動をするジュニアエンジニア向けの、求人集約・応募管理アプリです。Wantedly、CareerForum、japan-dev などのサイトから毎朝求人をスクレイピングします。AIによる履歴書フィードバック、ブラウザ内の履歴書エディタ、面接コーチ機能があり、その求人に本当に応募する価値があるかも判定します。

概要
JobEasy は、ジュニアエンジニアの就職活動を1つのアプリにまとめます。Wantedly、CareerForum、japan-dev から毎朝ジュニア向けの求人をスクレイピングし、その求人に応募する価値があるかを判定します。ブラウザを離れずに履歴書を調整でき、応募ごとにタスクリストと面接コーチも使えます。
このアプリを作って新しく学んだこと:
- Devise によるセッションベースの認証と、Pundit による認可
- JSON API とプレーンな HTML を対象にした、バックグラウンドジョブでの定期スクレイピング
- JWT 認証とコールバックを使った、サードパーティ API(OnlyOffice テキストエディタ)の連携
- RubyLLM 経由での OpenAI 連携と、レスポンスの JSONB 保存(RubyLLM Schema)
対象ユーザー
日本で就職活動をしているジュニアエンジニアです。1社目や2社目のエンジニア職に応募する人が多く、複数の求人サイトを同時に使っている人を想定しています。
課題
「LinkedIn でジュニア求人が見つからない」 多くのジュニアエンジニアは LinkedIn を求人サイトとして使っていますが、LinkedIn は最も競争が激しいサイトです。競争の少ない小さな求人サイトはたくさんありますが、毎日すべてをチェックし続けるのは現実的ではありません。
「自分は条件を満たしていないから、応募しない」 「経験2年以上」と書かれた時点で応募をあきらめるジュニアは多いです。実際には十分にチャンスがある場合でも、応募する価値があるかを簡単に判断する方法がありません。
「就活で使うツールが多すぎる」 就活の作業が、5〜10個の求人サイトのログイン、管理用のスプレッドシート、求人ごとに履歴書を直すための Microsoft Word、別タブで開く Claude や ChatGPT(面接対策用)に分散しています。
「応募や面接のあと、何をすればいいかわからない」 応募や面接を記録したあとは、次の行動がはっきりしません。フォローアップのリマインドもなく、面接で何を聞かれるかを整理する方法もありません。
機能
- 求人の一括集約
- 複数のサイト(Wantedly、CareerForum、japan-dev)の求人をスクレイピングし、1つのフィードにまとめます。毎日10個以上の求人サイトを手動でチェックする必要はありません。
- AIによる「応募する価値があるか」の判定
- 各求人をあなたの履歴書と照らし合わせ、構造化された形で率直にフィット感を判定します。「経験2年以上」と書かれていても、応募できる範囲かを確認する前にあきらめる必要はありません。
- オールインワンのワークフロー
- ブラウザ内の履歴書エディタで、アプリを離れたり Word を開いたりせずに、求人ごとに CV を調整できます。応募状況も別のスプレッドシートではなく、アプリ内で管理できます。
- 面接コーチとタスクリスト
- 応募ごとにチャット形式のコーチと ToDo リストがあり、次に何をすべきか、何をフォローアップすべきかで迷いません。

データベース設計
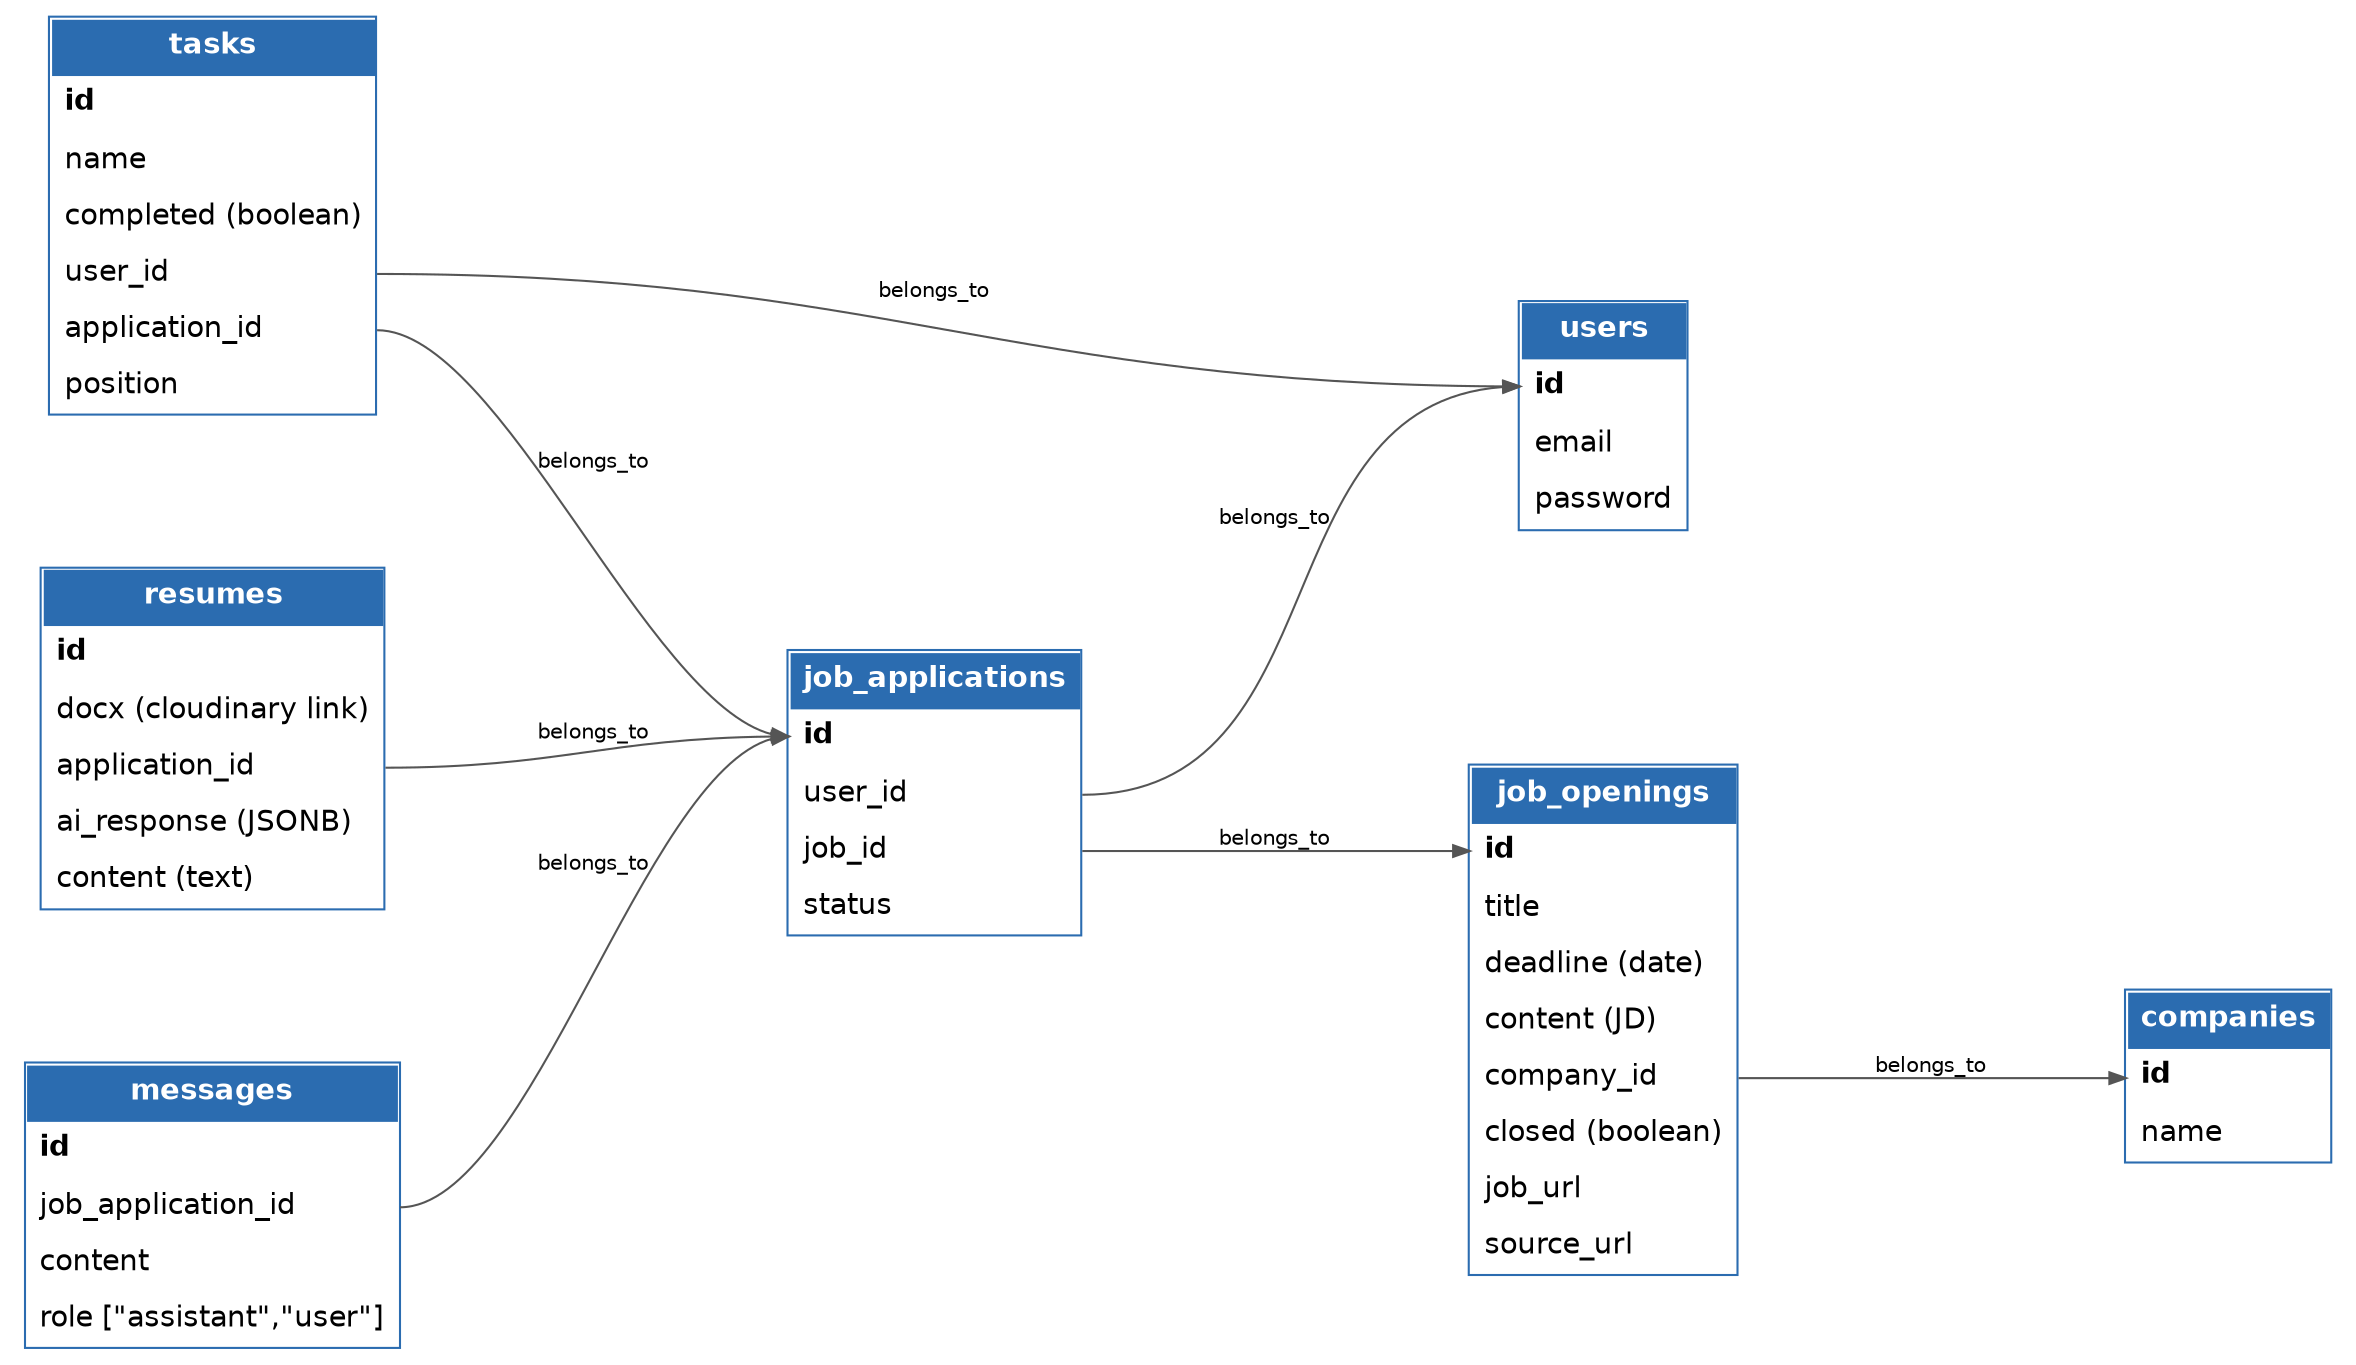
ポイント:
- Users と JobOpenings は、中間テーブル
job_applicationsで関連付けています。User は複数の job_applications を持ち、job_applications を通じて複数の job_openings を持ちます。 - Resumes と job_applications は 1:N の関係なので、
resumesテーブルに外部キーを持たせています。User は job_applications を通じて複数の resumes を持ち、各 Resume は1つの job_application に属します。
技術的な課題
OnlyOffice API 連携
アプリにテキストエディタを組み込むために、いろいろな選択肢を試しました。最終的に OnlyOffice を選んだ理由は次の3つです。
- UI が見やすい
- 同時保存ができる
- CV のインデント、太字などのスタイルを保持できる

全体の流れ:
- 履歴書をアップロード
- ユーザーが
.docxをアップロードすると、POST /resumesが呼ばれます。 - ファイルは、
Resumeインスタンスに Active Storage(Cloudinary)ファイルとして保存されます。 extract_contentが文書をテキストに変換し、Resumeのcontentとして保存します。- このインスタンス用に、ランダムなコールバックトークンを作成します。
- 完了後、ユーザーは履歴書の編集ページ(
GET /resumes/:id/edit)にリダイレクトされます。
- ユーザーが
- Rails が署名付きのエディタ設定を作成
ResumesController#editが OnlyOffice エディタ用の設定ハッシュを作り、JWT で署名します。- 設定は編集ページに埋め込まれ、ブラウザが
DocsAPI.DocEditorに渡し、OnlyOffice サーバーに送られます。 - JWT の構成:
- Header: HS256 アルゴリズム
- Payload: ドキュメント URL(Cloudinary URL)、ドキュメントキー、ファイルタイプ、コールバック URL、ユーザーのハッシュ
- Signature: Header と Payload を
ONLYOFFICE_JWT_SECRETで HS256 署名したもの
- ブラウザがエディタを表示
- ビューが OnlyOffice サーバーから
api.jsをスクリプトとして読み込みます。
- ビューが OnlyOffice サーバーから
- OnlyOffice がファイルを取得
- OnlyOffice サーバーが、共有シークレットで設定の JWT を検証します。
- Cloudinary URL から
.docxをダウンロードします。 - ファイルを変換し、
document.keyをキーにキャッシュします。このキーは保存のたびに変わります。
- ユーザーが編集
- エディタを閉じると保存が始まります。OnlyOffice が編集内容から完成した
.docxを作り、status: 2と完成ファイルへのリンクを付けて、コールバック URL にリクエストを送ります。
- エディタを閉じると保存が始まります。OnlyOffice が編集内容から完成した
- バックグラウンドジョブが新しいバージョンを保存
ResumeSaveJobが完成した.docxをダウンロードし、Cloudinary 上の古いファイルを新しいファイルに置き換えます。- Resume の
updated_atを更新します。これでdocument.keyが変わるため、次回のエディタセッションでは新しいファイルが読み込まれます。
求人スクレイパー
3つのバックグラウンドジョブを、rake タスクから起動します。このタスクを Heroku Scheduler で、毎日日本時間の朝9時に実行しています。

全体の流れ:
-
Heroku Scheduler が
rails jobs:scrapeを実行します。 ScrapeJapandevJob- Japan Dev の Meilisearch API にリクエストを送り、
juniorとnew_gradのシニオリティで絞り込みます。 - 各求人について、その会社の求人を API から取得し、詳細な職務内容と会社情報を得ます。
- HTML の職務内容を Nokogiri でプレーンテキストに変換します。
- リクエスト間に0.3秒の sleep を入れます。
- 結果を会社と求人のハッシュの配列に保存し、それをもとに
CompanyとJobOpeningのレコードを作成します。
- Japan Dev の Meilisearch API にリクエストを送り、
ScrapeCFNJob- 会社一覧 API の1〜12ページを、「IT」を含むカテゴリーで絞り込んで取得します。
- 各求人について、求人 API から職務内容と給与を取得します。正規表現で「円」で終わる金額を抽出します。
- 結果を会社と求人のハッシュの配列に保存し、それをもとに
CompanyとJobOpeningのレコードを作成します。
ScrapeWantedlyJob- 「Ruby」「Tokyo」「未経験」で検索した結果の1〜5ページを取得します。
- CSS セレクターで HTML から求人情報を抽出します。
- 各求人ページを開き、職務内容、会社情報、給与を取得します。
- 結果を会社と求人のハッシュの配列に保存し、それをもとに
CompanyとJobOpeningのレコードを作成します。
CV 提案のための RubyLLM スキーマ
履歴書の編集ページで「Ask JobEasy for suggestions」をクリックすると、Rails が履歴書のテキストと求人の職務内容を、RubyLLM 経由で OpenAI に送ります。構造化された回答を得るために、レスポンスを JSONB として保存しています。この過程で RubyLLM のスキーマ(AiResponseSchema)の使い方を学びました。
- 履歴書のテキストを取得
- アップロードの流れと同じで、ドキュメントは
Resumeに Active Storage(Cloudinary)ファイルとして保存されています。extract_contentがテキストに変換し、contentとして保存します。
- アップロードの流れと同じで、ドキュメントは
- ユーザーが提案をリクエスト
- ボタンが
POST /resumes/:id/recommendationsを送ります。
- ボタンが
- レスポンスの形を定義
ai_responseJSONB の形を、事前に定義します。
class AiResponseSchema < RubyLLM::Schema string :order_advice, description: "..." # プロジェクト/経験をどこに置くか string :summary_advice, description: "..." # 冒頭のサマリーの書き方 array :additional_advice, of: :string, description: "..." # 追加のアドバイス(最大5件) end - LLM を呼び出す
ResumesControllerのrecommendationsアクションが LLM を呼びます。
chat = RubyLLM.chat.with_schema(AiResponseSchema) response = chat.ask("You are a professional tech recruiter ... #{@resume.content} ... #{job_opening.title} ... #{job_opening.content} ...") -
構造化された結果を読み取って保存
- 提案を表示
- アドバイスは1件ずつカードとして表示されます。「×」をクリックすると
DELETE /resumes/:id/advices/:advice_idが送られ、そのアドバイスの id がai_response["dismissed"]に追加されます。
- アドバイスは1件ずつカードとして表示されます。「×」をクリックすると
完成したアプリ
アプリは jobeasy.space で試せます。